AI
Quantization: 딥러닝 경량화를 위한 정밀 이론과 적용 사례
sw.kim
2025. 4. 28. 15:20
딥러닝 모델이 점점 대형화됨에 따라, 모델을 경량화하는 기술은 선택이 아니라 필수가 되었다.
그중에서도 **Quantization(양자화)**는 가장 널리 쓰이는 경량화 기법이다.
이번 글에서는, Quantization의
- 정확한 수학적 정의
- 대표적인 방법별 특징
- Quantization 방법별 성능 비교
를 다룬다.
1. Quantization 수식 (현실적으로 많이 쓰이는 버전)
실제 많이 사용되는 양자화 수식은 다음과 같다.
Uniform Affine Quantization (Offset 포함)
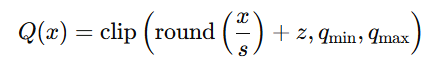
여기서,
- x : 부동소수점 입력값 (float32)
- s : scaling factor (양자화 단위)
- z : zero-point (offset, 정수화할 때 기준점 조정)
- qmin,qmax: 정수 표현 범위 (예: 8-bit int이면 0-255 또는 -128-127)
복호화(Dequantization)는 다음과 같이 한다:

Affine Quantization은 특히 0 주변 값들을 정확하게 보존해야 할 때 유리하다.
(예: 활성화 함수 출력값이 작은 경우)
Symmetric Quantization
특수한 경우로, offset을 0으로 가정하는 것도 있다:
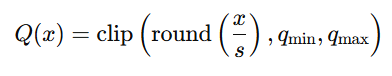
→ 주로 weight에 사용.
→ 연산 단순화 가능.
2. Quantization 방법론 요약
(1) Post-Training Quantization (PTQ)
- 특징: 모델을 학습한 뒤 바로 양자화.
- 장점: 빠르고 간단.
- 단점: 정밀한 제어가 어렵고, 민감한 모델에서는 정확도 하락.
대표 적용: MobileNetV2 (TensorFlow Lite)
(2) Quantization Aware Training (QAT)
- 특징: 학습 중에 양자화 효과를 시뮬레이션.
- 장점: 낮은 비트에서도 정확도 유지 가능.
- 단점: 학습 시간 증가.
대표 적용: EfficientNet, MobileBERT
(3) Mixed-Precision Quantization
- 특징: 레이어마다 다른 비트 수 사용 (예: 일부 8-bit, 일부 16-bit).
- 장점: 속도와 정확도 최적화.
- 단점: 복잡한 최적화 필요.
대표 적용: NVIDIA TensorRT, Qualcomm SNPE
3. Quantization 방법별 성능 비교 (논문 기반)
실제 논문의 일부 결과를 정리하면 다음과 같다. 다만, 많은 논문을 바탕으로 평균적인 값을 도출한 것이 아니기 때문에 참고용으로만 사용하길 권장한다.
모델 / 방법 / Top-1 Accuracy (%) / 원본 모델(FP32) 대비 감소량
| ResNet-18 | 4-bit | 51.6% | -18.1% |
| VGG | 4-bit | 67.2% | -4.4% |
| VGG | 4 bits weights, 8 bits activations | 70.5% | -1.1% |
| BERT-base | PTQ (8-bit) | 81.5 (GLUE score) | -2.5% |
| BERT-base | QAT (8-bit) | 83.1 (GLUE score) | -0.9% |
출처:
- [Banner et al., "Post Training 4-bit Quantization of Convolutional Networks for Rapid-Deployment", NeurIPS 2019]
- [Zafrir et al., "Q8BERT: Quantized 8Bit BERT", arXiv 2019]
요약:
- PTQ는 간편하지만 손실이 크다. (특히 MobileNet처럼 작은 모델은 민감함)
- QAT는 복잡하지만 정확도 손실을 최소화할 수 있다.
결론
Quantization은 단순히 수를 줄이는 작업이 아니라,
스케일링, 오프셋 조정, 정수 표현 범위 최적화 등 정교한 과정이 필요하다.
또한,
- Post-Training Quantization은 간편하지만 정확도 손실이 클 수 있고,
- Quantization Aware Training은 복잡하지만 고정밀을 유지할 수 있다.
어떤 방법을 선택할지는 모델 구조와 적용 환경에 따라 달라진다.
그리고 앞으로 ultra-low-bit quantization (4-bit 이하)까지 실용화가 가속될 것으로 예상된다.