CES: 여러 개의 In-Order IQ로 OoO를 구현할 수 있을까?
ISCA 1997 · Complexity-Effective Superscalar Processors
들어가며
CES(Complexity-Effective Superscalar Processors)는 OoO 실행 자체를 없애는 연구가 아니다. 문제의 출발점은 “명령어를 자유롭게 고르는 복잡한 Issue Queue 없이, 비슷한 ILP를 얼마나 얻을 수 있을까?”에 있다. 이 글은 CES 원 논문 전체에 대한 독립 재현이 아니라, 첨부된 Ballerino 논문의 Section II-B와 Figure 3(a), Figure 4에 실린 CES 설명 및 분석을 중심으로 정리한다.
1. 기존 OoO Issue Queue가 비싼 이유
일반적인 OoO IQ는 다양한 명령어의 operand readiness를 추적하고, 매 사이클 여러 issue port에 명령어를 배정한다. Wakeup logic은 결과 태그를 비교하며 준비 상태를 갱신하고, Select logic은 실행 가능한 후보 사이의 우선순위를 결정한다. IQ가 커지고 issue width가 늘어날수록 비교 및 선택 회로의 복잡성과 에너지 비용이 증가한다.
CES는 이 모든 후보를 한곳에서 비교하는 대신, 의존성이 연결된 명령어는 어차피 순서를 지켜야 한다는 사실을 활용한다.

통합 OoO IQ는 많은 후보를 고려하지만 CES는 여러 큐의 head를 중심으로 선택한다.
2. Dependence Chain이란?
다음 명령어에서 I2는 I1의 결과를 기다리고, I3는 I2의 결과를 기다린다.
I1: P10 = P2 + P3
I2: P11 = P10 * 2
I3: P12 = P11 + 5
이 명령어들을 같은 In-Order Queue에 넣으면 큐 내부에서 issue 순서를 자유롭게 재조정하지 못한다. 하지만 이 경우에는 의존성 때문에 원래도 I1 → I2 → I3 순서가 필요하다. 독립적인 다른 체인은 다른 큐에서 진행할 수 있다. 첨부 논문은 단일 DC 내부에서 하나의 producer와 하나의 consumer를 추적하는 단순화된 chain 정의를 사용한다. 분기가 갈라지거나 합쳐지는 경우에는 새로운 chain을 구성하거나 종료한다.
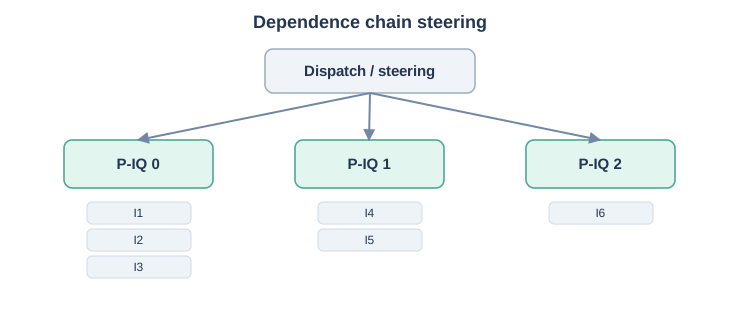
각 P-IQ는 하나의 의존성 체인을 중심으로 관리하며, 서로 다른 P-IQ의 head는 독립적으로 issue될 수 있다.
3. Steering은 어떻게 동작하는가?
CES는 Dispatch 시점에 명령어를 적절한 P-IQ로 보내는 Steering을 수행한다. 기존 P-IQ의 tail에 있는 producer를 소비하는 경우 같은 큐로 보낼 수 있고, 독립적인 명령어나 chain split이 발생한 명령어는 새 P-IQ가 필요할 수 있다. 한 큐의 공간이 부족해도 추가 큐가 필요할 수 있다.
핵심은 각 P-IQ 내부는 In-Order, P-IQ들 사이는 OoO에 가까운 실행이라는 점이다. 복잡한 통합 IQ 대신 여러 간단한 큐를 사용해 다수의 독립적 chain을 실행하는 것이 CES의 강점이다.
4. 가장 큰 약점: Ready 명령어가 큐를 차지한다
이제 모든 operand가 이미 준비된 독립 명령어 네 개가 도착했다고 가정하자.
I1: P10 = P2 + P3    // ready
I2: P11 = P4 + P5    // ready
I3: P12 = P6 + P7    // ready
I4: P13 = P8 + P9    // ready
사용할 수 있는 P-IQ가 세 개뿐이고 각 명령어가 새 chain을 시작해야 한다면 네 번째 명령어가 배치되지 못한다. 계산할 수 있는 명령어인데도 Steering Stall이 발생하는 것이다.
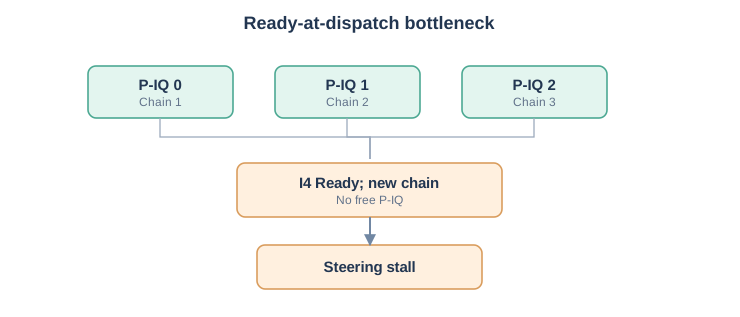
Ready-at-dispatch 명령어가 새로운 P-IQ를 요구하면 큐 부족이 발생할 수 있다.
Ballerino 논문의 CES 분석(Figure 4)은 P-IQ 할당 사건 중 72%, Steering Stall 사건 중 79%가 Ready 명령어에 기인한다고 보고한다. 이는 모든 CES 설계의 보편적 비율이 아니라 논문이 평가한 구성 및 워크로드의 결과다.
5. 긴 Cache Miss는 왜 다른 종류의 문제인가?
Load 결과를 기다리는 chain은 특정 P-IQ를 오랫동안 점유할 수 있다. 체인이 많아질수록 유효하게 추적해야 하는 chain head 수가 P-IQ 수를 초과하며, 새로운 명령어가 IQ에 들어오지 못할 수 있다. P-IQ의 entry가 남아 있더라도 다른 chain에 묶여 있으면 사용하지 못하는 상황이 발생한다.
그렇다고 P-IQ를 무한정 늘리면 면적 및 Steering 회로 비용이 올라간다. CES의 핵심 trade-off는 복잡한 IQ 선택 로직을 줄인 대신, dependence-aware steering과 많은 독립적 chain을 수용할 큐 자원을 필요로 한다는 것이다.
6. CES가 CASINO와 Ballerino로 이어지는 이유
CES는 register dependence를 잘 활용한다. 하지만 “이미 Ready인 명령어까지 왜 별도 P-IQ를 할당해야 할까?”라는 문제를 남긴다. 다음 편의 CASINO는 Readiness라는 다른 축에서 이 문제를 바라본다. 최종적으로 Ballerino는 CASINO의 빠른 Ready filtering과 CES의 병렬 Dependence Chain 관리를 결합한다.
기억할 문장: CES는 OoO를 없애는 것이 아니라, 여러 In-Order 큐 사이에서 OoO 효과를 얻도록 스케줄러를 분해한다.
참고 문헌과 근거
S. Palacharla, N. P. Jouppi, J. E. Smith, “Complexity-Effective Superscalar Processors,” ISCA 1997.
I. Jeong et al., “Reconstructing Out-of-Order Issue Queue,” MICRO 2022, Section II-B, Figure 3(a), Figure 4, Section III. 본 글에서 언급한 72% 및 79%는 후자 논문의 CES 재평가 수치다.