현대 CPU의 Out-of-Order Execution 이해
들어가며
OoO(Out-of-Order Execution)를 이해할 때 가장 중요한 것은 명령어 실행 순서와 결과를 확정하는 순서는 다를 수 있다는 사실이다. 프로그램은 순서대로 명령어를 정의하지만 CPU는 입력값이 준비된 명령어부터 실행할 수 있다. 이번 글에서는 OoO의 기본 파이프라인과 Register Renaming, PRF, ROB, 메모리 지연, Execution-Based Prefetching 및 Runahead까지 하나의 흐름으로 연결한다. CES·CASINO·Ballerino에 대한 상세 분석은 후속 글에서 별도로 다룬다.
1. 왜 명령어를 순서대로 실행하지 않을까?
I1: a = A[i];       // 긴 cache miss
I2: b = a * 2;      // I1 결과 필요
I3: c = x + y;      // I1과 독립적
I4: d = c + 5;      // I3 결과 필요
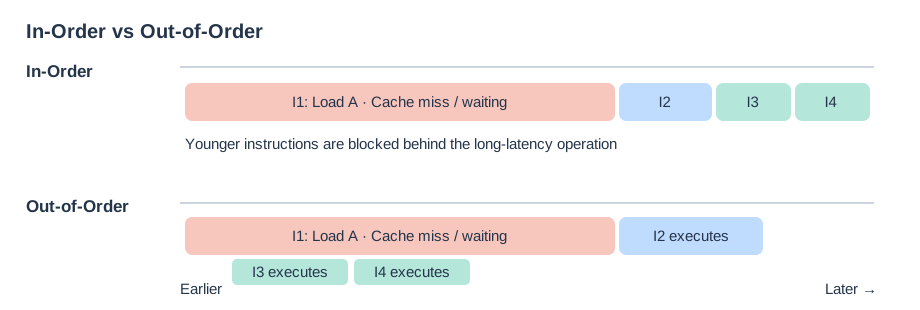
In-Order 코어가 I1 때문에 정체되면 뒤의 독립적인 I3, I4도 issue되지 못할 수 있다. 반면 OoO는 I1의 메모리 요청이 진행되는 동안 I3와 I4를 먼저 실행할 수 있다. 다만 I2는 I1의 실제 값이 필요하므로 앞서 실행할 수 없다.
아래 그림은 이를 위한 개념적 시간축이다. 실행 유닛이 여러 개이며 I3, I4가 독립적으로 진행할 수 있다고 가정했다.
2. OoO CPU의 실행 파이프라인
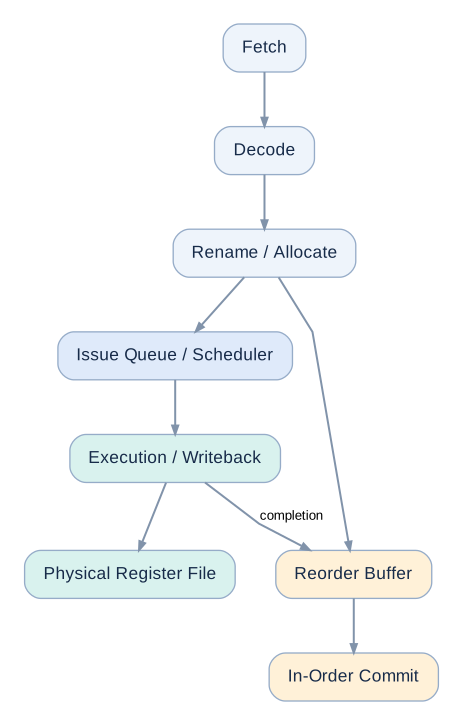
전형적인 OoO 코어는 명령어를 가져오고 해석한 뒤 물리 레지스터를 할당하며, Issue Queue에서 실행 가능한 명령어를 골라 실행한다. ROB는 명령어의 원래 순서와 완료 상태를 추적하여 순서대로 retire할 수 있게 한다.
그림의 화살표는 개념적 데이터 흐름이다. 실제 하드웨어에서는 IQ, ROB, Load/Store Queue, Register File이 병렬로 동작하고 여러 경로로 연결된다.
3. Register Renaming은 무엇을 해결할까?
I1: R1 = R2 + R3
I2: R4 = R1 * 2
I3: R1 = R5 + R6
I4: R7 = R1 + 1
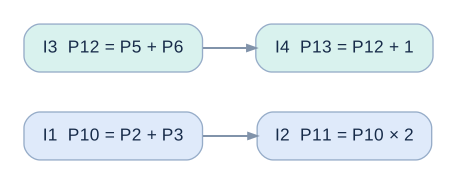
I1과 I3가 모두 R1을 사용하더라도 같은 물리적 값 버전을 뜻하지 않는다. Rename은 새 destination마다 다른 Physical Register를 할당할 수 있다.
I1: P10 = P2 + P3
I2: P11 = P10 * 2
I3: P12 = P5 + P6
I4: P13 = P12 + 1
그 결과 I1→I2와 I3→I4라는 독립적인 두 개의 RAW 의존성 체인을 얻는다. Register Renaming은 WAR·WAW라는 이름 의존성을 제거하지만, 값 자체가 필요한 RAW 의존성은 제거하지 않는다.
4. PRF와 ROB를 왜 구분해야 할까?
Architectural Register는 ISA가 프로그램에 제공하는 레지스터 이름(RAX 등)이고, Physical Register는 실제 CPU 내부의 값 저장 공간이다. Rename map은 현재 논리 레지스터가 어느 물리 레지스터의 값 버전을 가리키는지 알려준다.
I1: P10 = LOAD [A]      // DRAM에서 대기
I2: P11 = P2 + P3       // 결과 42
I3: P12 = P11 * 2       // 결과 84
I2가 계산을 마쳤다면 결과 42는 P11에 기록되고 I3는 I2의 Commit을 기다리지 않고 그 값을 사용할 수 있다. Forwarding/Bypass도 이 값 전달에 참여할 수 있다. 그러나 I1이 아직 완료되지 않았다면 I2와 I3는 ROB에서 아직 retire할 수 없다.
Execute/Writeback은 값의 생산, Commit/Retirement는 아키텍처 상태의 확정이다. PRF 기반 설계에서 Commit은 결과를 ROB로 옮기는 동작이 아니다. 새 물리 레지스터 버전이 확정되고 이전 버전은 안전한 시점에 회수된다.
5. Speculation과 Flush
Branch predictor가 잘못된 경로를 선택하면 그 경로에서 실행된 명령어들을 squash한다. 이때 해당 명령어의 물리 레지스터에 남아 있는 비트를 반드시 0으로 지울 필요는 없다. 잘못된 버전의 매핑을 복구하고, 물리 레지스터를 안전하게 재사용 가능하도록 관리하면 된다.
정상 실행에서도 완료된 명령어가 즉시 Commit되는 것은 아니다. 앞선 오래된 명령어, 예외 처리, 분기 검증, 메모리 순서와 같은 제약을 충족해야 한다. Store의 Commit과 실제 캐시 계층에 반영되는 시점 또한 다를 수 있다.
6. OoO도 왜 메모리 때문에 멈출까?
ROB의 Head에 있는 오래 걸리는 load가 retire되지 못하는 동안 뒤의 완료된 명령어들도 ROB를 점유할 수 있다. ROB가 가득 차면 새로운 명령어를 할당하지 못해 미래의 독립적인 load를 더 발견하기 어려워진다. 이는 유한한 instruction window가 갖는 한계다.
ILP는 독립적인 명령어를 겹쳐 실행하는 능력이고, MLP는 독립적인 메모리 요청을 겹쳐 진행하는 정도다. 예를 들어 독립적인 네 load는 병렬로 처리할 수 있지만, p = p->next를 반복하는 한 개의 pointer chain에서는 다음 주소가 이전 load 결과에 의존한다.
즉, 메모리 지연을 숨기는 것은 DRAM 자체를 빠르게 만드는 일이 아니라 유용한 작업을 지연과 중첩시키는 일이다.
7. Prefetching과 OoO는 같은 분류일까?
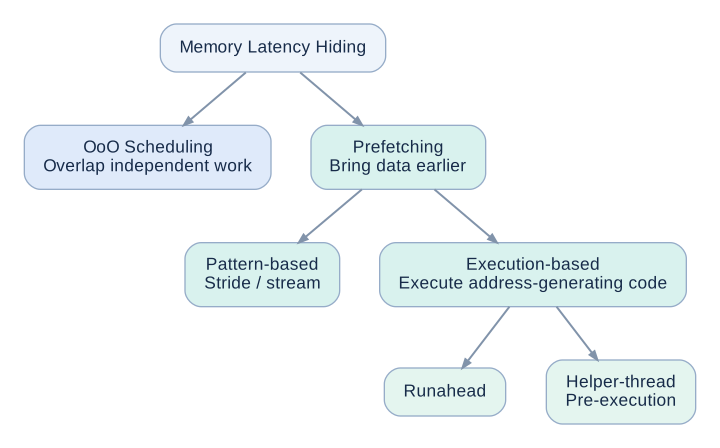
아니다. OoO는 기존 프로그램 명령어의 실행 순서를 동적으로 조정하고, Prefetching은 미래에 필요할 데이터를 실제 사용보다 일찍 요청한다. 둘은 함께 사용할 수 있으며, In-Order 코어에도 Prefetcher가 존재할 수 있다.
Stride·Stream Prefetcher는 관측된 접근 주소의 패턴을 이용한다. 반면 Execution-Based Prefetching은 주소를 만들어내는 프로그램 명령어를 직접 실행하거나 필요한 instruction slice를 실행한다. Runahead 및 helper-thread pre-execution은 이 범주에 속하는 대표적인 접근이다.
8. Runahead Execution은 어떻게 작동할까?
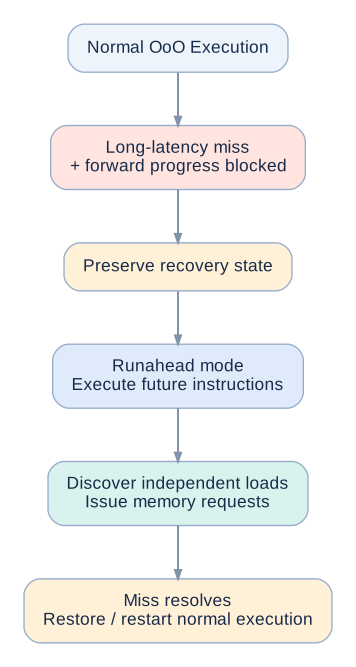
고전적인 Runahead는 긴 cache miss 때문에 정상적인 OoO 실행이 충분히 진행되지 못할 때 시작할 수 있다. 복구 가능한 실행 상태를 보존한 뒤 미래 명령어를 투기적으로 실행한다. 이때 발견한 독립적인 load는 메모리 요청을 생성해 미래의 정상 실행에 도움을 줄 수 있다. 원래의 miss가 완료되면 Runahead 실행 상태를 버리고 정상 실행을 재개한다.
Runahead 중 계산 결과는 정상 명령어처럼 retire하지 않는다. 그러나 발생시킨 메모리 접근은 cache를 채울 수 있다. 다만 미완료 load의 값에 의존해 주소를 계산해야 하는 경우에는 그 주소를 알아낼 수 없을 수 있다. 고전적인 Runahead는 이런 값을 invalid로 추적한다.
9. Helper Thread와 Runahead 비교
두 기법의 차이는 실행하느냐 예측하느냐가 아니다. 둘 다 프로그램 코드의 실행을 통해 주소를 발견할 수 있다. 차이는 어느 컨텍스트에서, 어떤 명령어를, 언제 실행하느냐에 있다.
구분RunaheadHelper-thread pre-execution
| 구분 | Runahead | Hepler-thread pre-execution |
| 실행 위치 | 일반적으로 메인 코어의 투기적 모드 | 별도 실행 컨텍스트·스레드 |
| 실행 범위 | 미래 명령어 스트림 | 전체 또는 Pruned instruction slice |
| 시작 조건 | 대표적으로 긴 메모리 정체 | 별도 트리거 또는 프로그램 기반 |
| 결과 | 정식 Commit 없이 프리페칭 효과 | 보조 실행의 주소·프리페칭 효과 활용 |
10. 다음 글로 이어지는 질문
OoO가 유용한 명령어를 빠르게 발행하는 것은 분명 유리하다. 하지만 Wakeup/Select는 넓고 큰 Issue Queue에서 에너지와 타이밍 비용이 커질 수 있다. 이 비용을 낮추면서 비슷한 병렬성을 확보하는 접근이 CES(ISCA 1997), CASINO(HPCA 2020), Ballerino(MICRO 2022)이다.
이 세 연구는 별도 글에서 각각의 문제 정의, 핵심 아이디어, 구조, 한계 및 평가 결과를 구분해 살펴볼 것이다.