MICRO 2022 · Reconstructing Out-of-Order Issue Queue
들어가며
Ballerino의 핵심 가설은 CES와 CASINO의 약점이 상호보완적이라는 것이다. CES는 의존성 chain을 잘 분리하지만 Ready 명령어가 P-IQ를 차지하고, CASINO는 Ready 명령어를 먼저 처리하지만 마지막 In-Order IQ의 Cache-Miss Blocking에 취약하다.
논문의 해결책은 S-IQ와 clustered P-IQ를 결합하고, Memory-Dependence-Aware Steering과 P-IQ Sharing을 추가하는 것이다. 여기서는 첨부한 MICRO 2022 원문 Figure 5–17을 중심으로 원리와 결과를 정리한다.
1. 무엇을 대체하려는가?
기존 8-wide OoO CPU의 통합 IQ는 다수의 in-flight instruction을 대상으로 Wakeup 및 Select를 수행한다. Ballerino는 이를 앞단의 S-IQ와 다수의 단순한 In-Order P-IQ로 대체한다. 그러나 ROB, Register Renaming, PRF 등의 일반적인 OoO 실행 기반이 완전히 사라지는 것은 아니다. 논문 Figure 7에서 새롭게 구성하는 핵심은 Issue Scheduling 부분이다.

S-IQ는 Ready 명령어를 Issue하고, 나머지는 의존성에 따라 P-IQ로 배치한다.
P-IQ와 S-IQ 모두 실행 유닛으로 issue할 수 있다.
2. Step 1, CES + CASINO
S-IQ는 Dispatch 시점에 Ready인 명령어를 우선 issue한다. 이에 따라 CES에서 새 P-IQ를 차지하던 짧은 Ready chain들을 앞단에서 처리한다. S-IQ에서 처리하지 못하는 명령어들은 Register Dependence를 따라 병렬 P-IQ로 배치된다.
예를 들어 I1 load가 miss를 낸 상태에서 I2가 그 결과를 기다린다면, I2는 P-IQ에 저장될 수 있다. 반면 I3, I4처럼 입력이 준비된 명령어들은 S-IQ에서 issue 기회를 얻는다. P-IQ에 들어간 명령어가 다시 S-IQ로 돌아가는 구조는 아니다.
논문 Figure 13의 단계별 평가에서 S-IQ 도입은 Ready 명령어로 인한 Steering Stall을 줄이고 성능을 높였다. 논문은 Step 1에서 S-IQ가 동적 명령어의 41%를 투기적 issue 방식으로 처리했다고 보고한다.
3. Step 2, Memory-Dependence-Aware Steering
CES의 Dependence Chain 배치는 주로 Register Dependence를 기준으로 한다. 그러나 Store와 Load 사이에는 Register Tag로 드러나지 않는 Memory Dependence가 존재할 수 있다.
I1: STORE [X], P10
I2: P11 = LOAD [X
I2가 I1이 기록한 값에 의존할 가능성이 있다면, 두 명령어를 각기 다른 P-IQ로 관리하는 것은 불필요한 자원 점유를 초래할 수 있다. Ballerino는 Store Set 기반 Memory Dependence Prediction을 확장해 Producer Store 위치 정보를 유지하고, 예측된 M-dependence를 Register Dependence보다 우선하여 Steering에 활용한다.
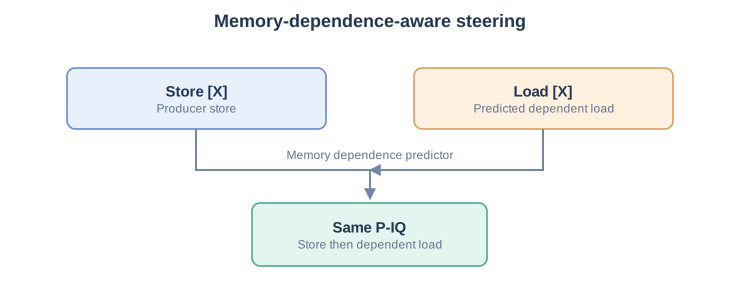
예측된 Store–Load Memory Dependence가 Register Dependence와 별개로 P-IQ 배치를 결정할 수 있다.
논문은 Step 1 분석에서 P-IQ head의 issue stall 중 약 9%가 M-dependent load의 producer store 대기와 관련 있다고 보고한다. MDA Steering은 이를 완화하고 Scheduling Window가 더 빠르게 확장되도록 만든다.
4. Step 3, P-IQ Sharing
긴 Load가 완료되지 않은 동안 해당 Dependence Chain은 P-IQ의 head에서 기다린다. 그러나 하나의 짧은 chain이 P-IQ 전체를 차지할 필요는 없을 수 있다. 논문은 P-IQ의 entry와 read port 활용률이 낮다는 점을 관찰한다. 기존 Step 2 설계의 P-IQ가 실제로 issue한 시간은 평균 약 6%라고 보고한다.
이를 해결하기 위해 하나의 물리 P-IQ를 두 개의 논리적 FIFO partition으로 나눌 수 있도록 설계한다. Partition마다 head/tail pointer를 두지만, 한 사이클에 한 dependence head만 선택해 추가 read port 비용을 억제한다.
하나의 P-IQ가 서로 다른 두 Dependence Chain을 저장하고 Ready head를 선택할 수 있다.
단순히 남은 공간을 아무 때나 나누는 것은 아니다. 실제 설계는 큐 포인터가 같은 절반에 존재하는 경우 등에 Sharing을 제한하여 구현을 단순화한다(논문 Figure 9).
5. 세 단계의 차이를 기억하는 방법
| 구성 요소 | 해결하려는 병목 | 역할 |
| S-IQ | Ready 명령어가 별도 P-IQ를 차지 | Ready-at-dispatch filtering |
| MDA Steering | Store–Load 의존성을 놓친 잘못된 큐 배치 | MDP 정보를 통해 관련 instruction을 Steering |
| P-IQ Sharing | 짧거나 대기 중인 chain이 큐 공간을 비효율적으로 사용 | 하나의 P-IQ에서 여러 논리적 chain 유지 |
이 세 메커니즘은 Prefetcher를 직접 추가하지 않는다. 정상 실행에서 명령어를 효율적으로 Issue하도록 설계된 것이다. 반면 Runahead는 미래 명령어의 투기적 실행을 통해 별도 Prefetch 효과를 얻으려 한다.
6. 성능 결과는 무엇을 의미하나?
논문은 SPEC CPU2006/2017 workload의 대표 구간을 대상으로 Cycle-Level x86 Simulator와 DRAM 모델을 이용했다. 에너지는 수정된 McPAT 22nm 모델에서 추정했다.
| 구성 | In-Order baseline 대비 IPC | 8-wide OoO 대비 성능 |
| CES | 약 2.4× | 낮음 |
| CASINO | 약 2.1× | 낮음 |
| Ballerino (1 S-IQ + 7 P-IQ) | 약 2.7× | 약 93% |
| Ballerino-12 (1 S-IQ + 11 P-IQ) | 약 2.8× | 약 98% |
Figure 11에서 Ballerino-12는 기존 OoO보다 약 2% 낮은 성능을 보인다. 논문 결론은 같은 OoO 대비 Ballerino-12의 Core-Wide Energy가 약 19% 낮고 에너지 효율(Performance per Energy)이 약 20% 높다고 보고한다. 20%는 전체 에너지 소모 감소율이 아니라 성능을 함께 고려한 효율 증가율이다.
Figure 17(c)는 P-IQ를 늘릴수록 성능이 개선되지만 약 11개 P-IQ 이후 추가 이득이 작아진다는 경향을 보여준다. 이는 실험 대상 구성에서 사용 가능한 ILP·MLP의 상당 부분을 이미 활용했음을 시사한다.
7. 논문의 의의와 해석 범위
Ballerino가 보여준 것은 완전한 OoO IQ를 그대로 유지하지 않아도 충분히 유사한 스케줄링 성능을 낼 수 있다는 설계 가능성이다. 다만 평가에 사용된 캐시 계층, 8-wide baseline, 22nm 에너지 모델, SPEC 구간을 벗어난 일반화에는 주의해야 한다.
또한 Ballerino의 성능 향상은 메모리 지연을 실제로 낮췄기 때문이라기보다 Ready 명령어를 더 빠르게 발행하고, 독립적인 Dependence Chain을 더 효율적으로 관리했기 때문이라고 해석해야 한다.
기억할 문장: CES의 chain 분리 + CASINO의 Ready filtering + MDA Steering + P-IQ Sharing = Ballerino의 효율적인 동적 스케줄링.
참고 문헌과 근거
I. Jeong, J. Lee, M. K. Yoon, W. W. Ro, “Reconstructing Out-of-Order Issue Queue,” MICRO 2022, DOI 10.1109/MICRO56248.2022.00023.
특히 Figure 5(설계 단계), Figure 7(코어 구조), Figure 8(MDA Steering), Figure 9(P-IQ Sharing), Figure 11(성능), Figure 13(기술별 기여), Figure 15–17(에너지와 Sensitivity Analysis)를 참고했다.
'CPU' 카테고리의 다른 글
| CES: 여러 개의 In-Order IQ로 OoO를 구현할 수 있을까? (0) | 2026.10.20 |
|---|---|
| 현대 CPU의 Out-of-Order Execution 이해 (0) | 2026.10.20 |